
LLM は魅力的に見える提案をしてくれますが、実際に提案に従ってみると全然大したことがない結果になり肩透かしを食うことがよくあります。
本稿ではスタンフォード大学のグループによる一連の研究 Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers(LLMは斬新な研究アイデアを生み出せるか? 100名以上のNLP研究者を対象とした大規模な人間を対象とした研究)と The Ideation–Execution Gap: Execution Outcomes of LLM-Generated versus Human Research Ideas(構想と実行のギャップ:LLMが生成した研究アイデアと人間が考案した研究アイデアの実行結果)を題材にこの問題について考えます。
人間と LLM の研究アイデアバトル
第一の研究 [Si+ ICLR 2025] では、研究費申請書を念頭に LLM に研究アイデアの提案書を書かせました。LLM に大まかに研究分野を与えたのち、RAG の要領で関連する既存論文を与え、それをもとに新しいアイデアを考えさせました。
この研究の大きな特徴は、49 名の実在の研究者を雇って LLM による実験と同じ分野・同じフォーマットで研究アイデアの提案書を書かせ、さらに 79 名の査読者を雇って、査読者にはその提案書が LLM によるものか、実在の研究者によるものかを明かさずに評価したもらったことです。提案者も査読者も、平均してすでに 10 本程度の論文出版経験があり、500 程度の引用を得ている経験のある研究者です。研究者には 10 日かけて提案書を書いてもらい、基本報酬として 300 ドル(約 4.8 万円)を与え、査読でよい評価を得た上位 5 名には追加で 1000 ドル(約 16 万円)を与えることで、モチベーションを担保しました。査読者は 1 週間かけて、一人あたり 2 から 7 件の提案書を査読し、一つあたり 25 ドル(約 4000 円)の報酬を与えます。この人件費だけで 450 万円くらいかけた気合の入った研究です。さすがスタンフォード大学、お金がありますね。
LLM による研究アイデアは斬新で人間より優れている
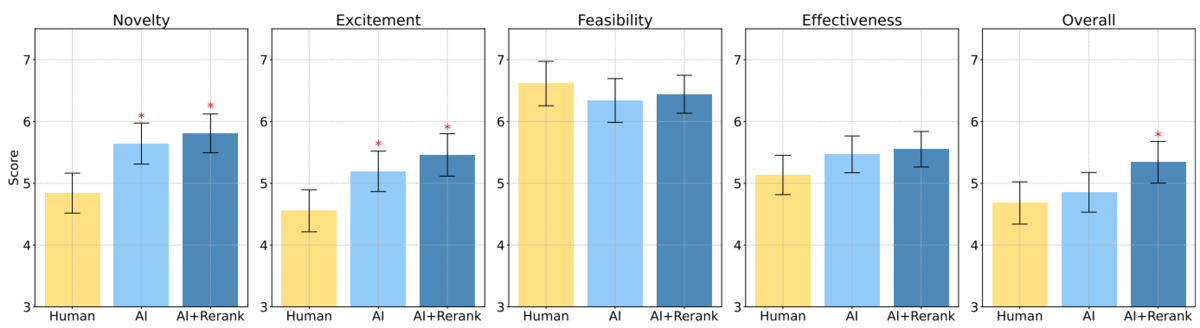
査読者は各提案書を「新規性 (Novelty)」「興奮度 (Excitement)」「実行可能性 (Feasibility)」「効果性 (Effectiveness)」「総合評価 (Overall)」の観点で採点しました。
結果、AI による提案書は人間の提案書よりも明確に新規性と興奮度が高く、実行可能性はわずかに低く、効果性と総合評価ではわずかに上回るという結果になりました。
人間側は素人ではなく、すでに 10 本程度の論文出版経験があり、500 程度の引用を得ている経験のある研究者です。それでもなお、公平な土俵で LLM が研究者に匹敵する結果を出したことはなかなかインパクトがあります。
じゃあ AI が提案した研究アイデアを実際に遂行したらどうなるのか
この研究には、同じグループによる続きがあります [Si+ arXiv 2025]。第一の研究で作った LLM によるアイデアと、人間によるアイデアを、実際に研究遂行して、論文にまとめました。
このために、遂行役となる研究者を改めて 43 名雇いました。この研究者に、第一の研究で作った研究提案書を渡し、3 か月かけて実験等を行い、4 ページの論文にまとめてもらいます。このとき、与えられた提案書が LLM によるものなのか、人間によるアイデアなのかは遂行者には伝えません。分からないまま、可能な限り忠実に遂行してもらいます。遂行者には基本報酬として 600 ドル(約 10 万円)に加えて時給 20 ドル(約 3200 円)を与えたほか、遂行した研究はさらに発展させて自分の研究として発表できるようにすることで、モチベーションを担保しました。遂行者は平均して 100 時間かけてこのプロジェクトに取り組みました。第一の研究と同様に査読者を雇い、完成した論文を査読してもらいました。今回は人件費だけで 2000 万円くらいかかっています。さすがスタンフォード大学、お金がありますね(再確認)。
LLM の研究アイデアを実際にやってみたらしょぼかった
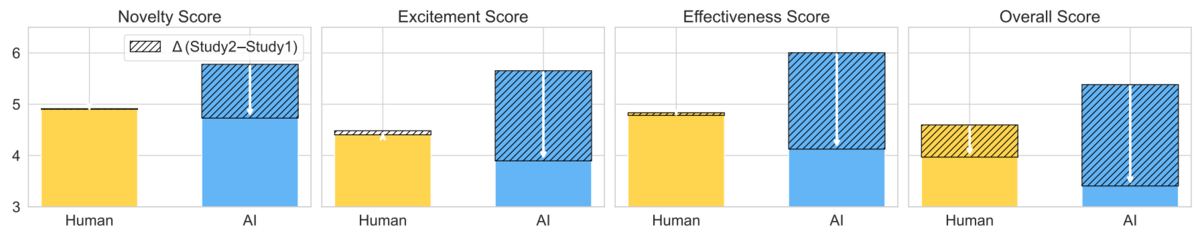
第一の研究と同様に「新規性 (Novelty)」「興奮度 (Excitement)」「効果性 (Effectiveness)」「総合評価 (Overall)」の観点で採点しました。実際に実行したあとの話なので「実行可能性 (Feasibility)」は今回は採点しません。
第一の研究では、新規性や興奮度で AI のアイデアが人間を上回っていましたが、実行後の評価では AI の新規性と興奮度が大幅に下がり、人間を下回るほどになりました。上図の網掛け部分が、実行前後で変化した部分です。一方、人間のアイデアは実行前後でスコアはあまり変わらず、結果的に AI を上回る結果になっています。
LLM の研究アイデアには、それができるならするに越したことはないが実際は無理なことが含まれる
実際に提案書と論文と査読結果を分析してみると、LLM の研究計画には無茶な部分があることが分かりました。
たとえば、LLM は専門家を雇って大規模な評価を行うことを提案するのが好きであり、LLM が書いた「社会言語学的なロールプレイのプロンプト法」という研究提案書では、様々な言語のネイティブスピーカーや専門家を雇って調査を行うことを提案しています。アイデア段階ではこの点が高く評価されていました。しかし遂行者が実験する段になるとこの規模で専門家を雇って実験することが不可能であることが判明し、結局 LLM-as-a-judge をネイティブスピーカーの代わりに使って妥協することになりました。このために、論文の査読では、「LLM による自動評価では有効性が判断できない」ということで低くスコアが付けられてしまいました。
逆に、人間が作る研究計画者では、このような無理のある提案をすることは抑えられており、その結果アイデア段階では派手に見えないものの、ちゃんと実行できるものになっている傾向があります。
LLM の研究アイデアはうまくいきそうに見えるが、実際にやってみたらうまくいかない
計画書段階で「これを実行するとこのような結果と考えられる」と宣言することがありますが、計画書だけを査読するとき、評価者は性善説的にそうなるのだろうと信じたうえで評価することが多いです。もちろん、流石にあり得ないようなことを言っていたら企画書段階でツッコミが入るでしょうが、傾向としては、そう言うのならそうなるのだろうという気持ちで評価してしまいます。このため、企画書段階ではビッグマウス的な AI が高く評価される傾向にあります。しかし、実験を行い結果が判明すると、LLM が宣言した通りにはなっておらず、提案がハリボテであることが露呈してしまい、低くスコアが付けられてしまいます。
一方、優秀な研究者は誠実でビッグマウスにはなりづらく、企画書としての派手さはないものの、宣言と実際の乖離が小さい堅実な計画書を書くことができます。
LLM の研究アイデアには、比較するべき対象が欠けている
研究においては既存研究と適切に比較をすることが不可欠ですが、LLM の研究計画はこの部分が弱いことが判明しました。詳しく調査してみると、LLM の計画書で述べられている比較対象は必要よりも弱いことが多く、論文に必要な比較研究が欠ける、あるいは必要な比較を追加すると提案の有効性が霞むということが起こります。
これは、LLM が「意図的」に、研究計画書が魅力的に見えるように弱い比較相手を持ち出している可能性と、LLM の「盲点」により、適切な既存研究を探し切れていない可能性の両方があります。この問題は AI に文書を作らせるときによく起こります。現代の AI は文書を作るとき、文書内の一貫性を重視する傾向があり、文書の一貫性に反するような素材はそもそも探そうとすらしないという確証バイアス的な作用がしばしば生じます。そのようにして作られた文書は一見すると一貫性があり優れているように見えるのですが、論文の査読のように関連研究まで見る詳しい調査を行うと、文書の外の世界に、文書の妥当性を根幹から揺るがすような事実が見つかることがあります。
一方、優秀な研究者は科学の作法に従って誠実に比較研究をする傾向があり、かつ分野の地図が頭の中にあるので、適切な既存研究を引き出しやすいと考えられます。そのため、計画段階から適切に設計および対策ができている傾向があり、実行を経ても有効性が下がりづらいと考えられます。
LLM によるアイデア出しのこれから
皆さんも AI を使っていて、似たような肩透かしを食ったことがあるのではないでしょうか。私はしょっちゅうあります。AI をアイデア出しに使うことが増えてきた昨今ですが、このような傾向があることは肝に銘じておきましょう。LLM のアイデアを 2000 万円かけて実行したらしょぼかったという事態が実際に起こったら目も当てられません。
本稿は LLM のカスのコンサル問題と題しましたが、このことは現象としてカスのコンサルのように見えるだけでなく、発生原因も根っこでは一致していると思われます。現実でカスのコンサルのようなことが起こるのは、受注さえしてしまえば報酬が得られるというような短期的な目線によることがあるかと思いますが、LLM の訓練においても、提案さえ魅力的であれば、グッドボタンという報酬が支払われてそのような出力が強化されます。実行結果が悪いことがあとで判明しても、時間が経ってしまったことと提案者と遂行者が分離しているせいで責任が有耶無耶になり、適切にフィードバックができず、是正されづらいという構造も共通しているように思われます。計画倒れするのは LLM の能力が低いという見方もできますが、LLM はこの構造を(ずる)賢く活用して、有耶無耶にしつつうまく報酬をかすめ取ることに成功していると見ることもできます。このことは以前著した 人間を騙してサボるAIたち - ジョイジョイジョイ の議論とも共通です。
最近はエージェントの発達により、LLM が遂行側の責任も担うようになり、この溝は少しずつ埋まっているように思いますが、それでもなお、提案書の見栄えをよくするという圧力は今でも強くあるので LLM の出力が実力以上の見栄えになってしまうことは解決されていませんし、ここまで見てきたように、長期にわたる計画の事例を得てそれを正しく評価することには多くの時間とお金がかかるので、AI のお家芸であるスケーリングによる解決をするのが経済的に難しいという問題もあります。人間界でも、コンサル問題をはじめ、助成金の獲得競争や面接時の猫かぶりなど、同様の構造の問題は根強く生き続けており、完璧に解決することは困難なように思われます。とはいえ現状の LLM は基礎能力が高い割にはこの問題に陥りすぎているようにも思うので、改善の余地は十分あるように思われます(しかし、LLM の基礎能力が高いように見えている、というのも実はハリボテの同じ構造かもしれません。)
LLM が立派なコンサル、あるいは立派なエージェントに成長する日は来るのでしょうか。皆さんも考えていただければ幸いです。
